วิวัฒนาการของ Virtual Machine: จาก Bare-Metal สู่ยุค AI Local
Hypervisor, HCI และ GPU Virtualization ในมุมมองวิศวกร พร้อมตัวเลข Consolidation Ratio ที่ออกแบบตามได้จริง
- บน Bare-Metal ใช้ CPU/RAM ได้จริงเพียง 10–15% เปลืองทั้งพื้นที่และค่าไฟ
- Hypervisor และ HCI รวมทรัพยากรเป็น Pool เดียว แล้วย้าย VM อัตโนมัติด้วย Live Migration
- Broadcom/VMware เปลี่ยนเป็น Subscription องค์กรจึงมองหา Hypervisor ทางเลือก
- งาน AI ในองค์กรต้องมี GPU: Passthrough / vGPU / MIG และ Sweet Spot 1 Host : 30–50 VMs
ทำไมต้อง Virtualization
ในสมัยเริ่มแรกของการใช้งาน Server 1 Application = 1 Physical Server จนเกิดปัญหา 3 ประการที่ Virtualization เข้ามาแก้ไข
1 App = 1 Physical Server
Web, Database และ Mail ต้องซื้อ Server แยกกัน 3 เครื่อง
Underutilization
CPU และ RAM ใช้จริงเพียง 10–15% ของศักยภาพ
พื้นที่ & พลังไฟ
Rack เต็ม Data Center ค่าไฟและการระบายความร้อนสูง
Provisioning ช้า & Maintenance สูง
ต้องจัดหาวนและติดตั้งหลายสัปดาห์
จาก Bare-Metal สู่ AI Local
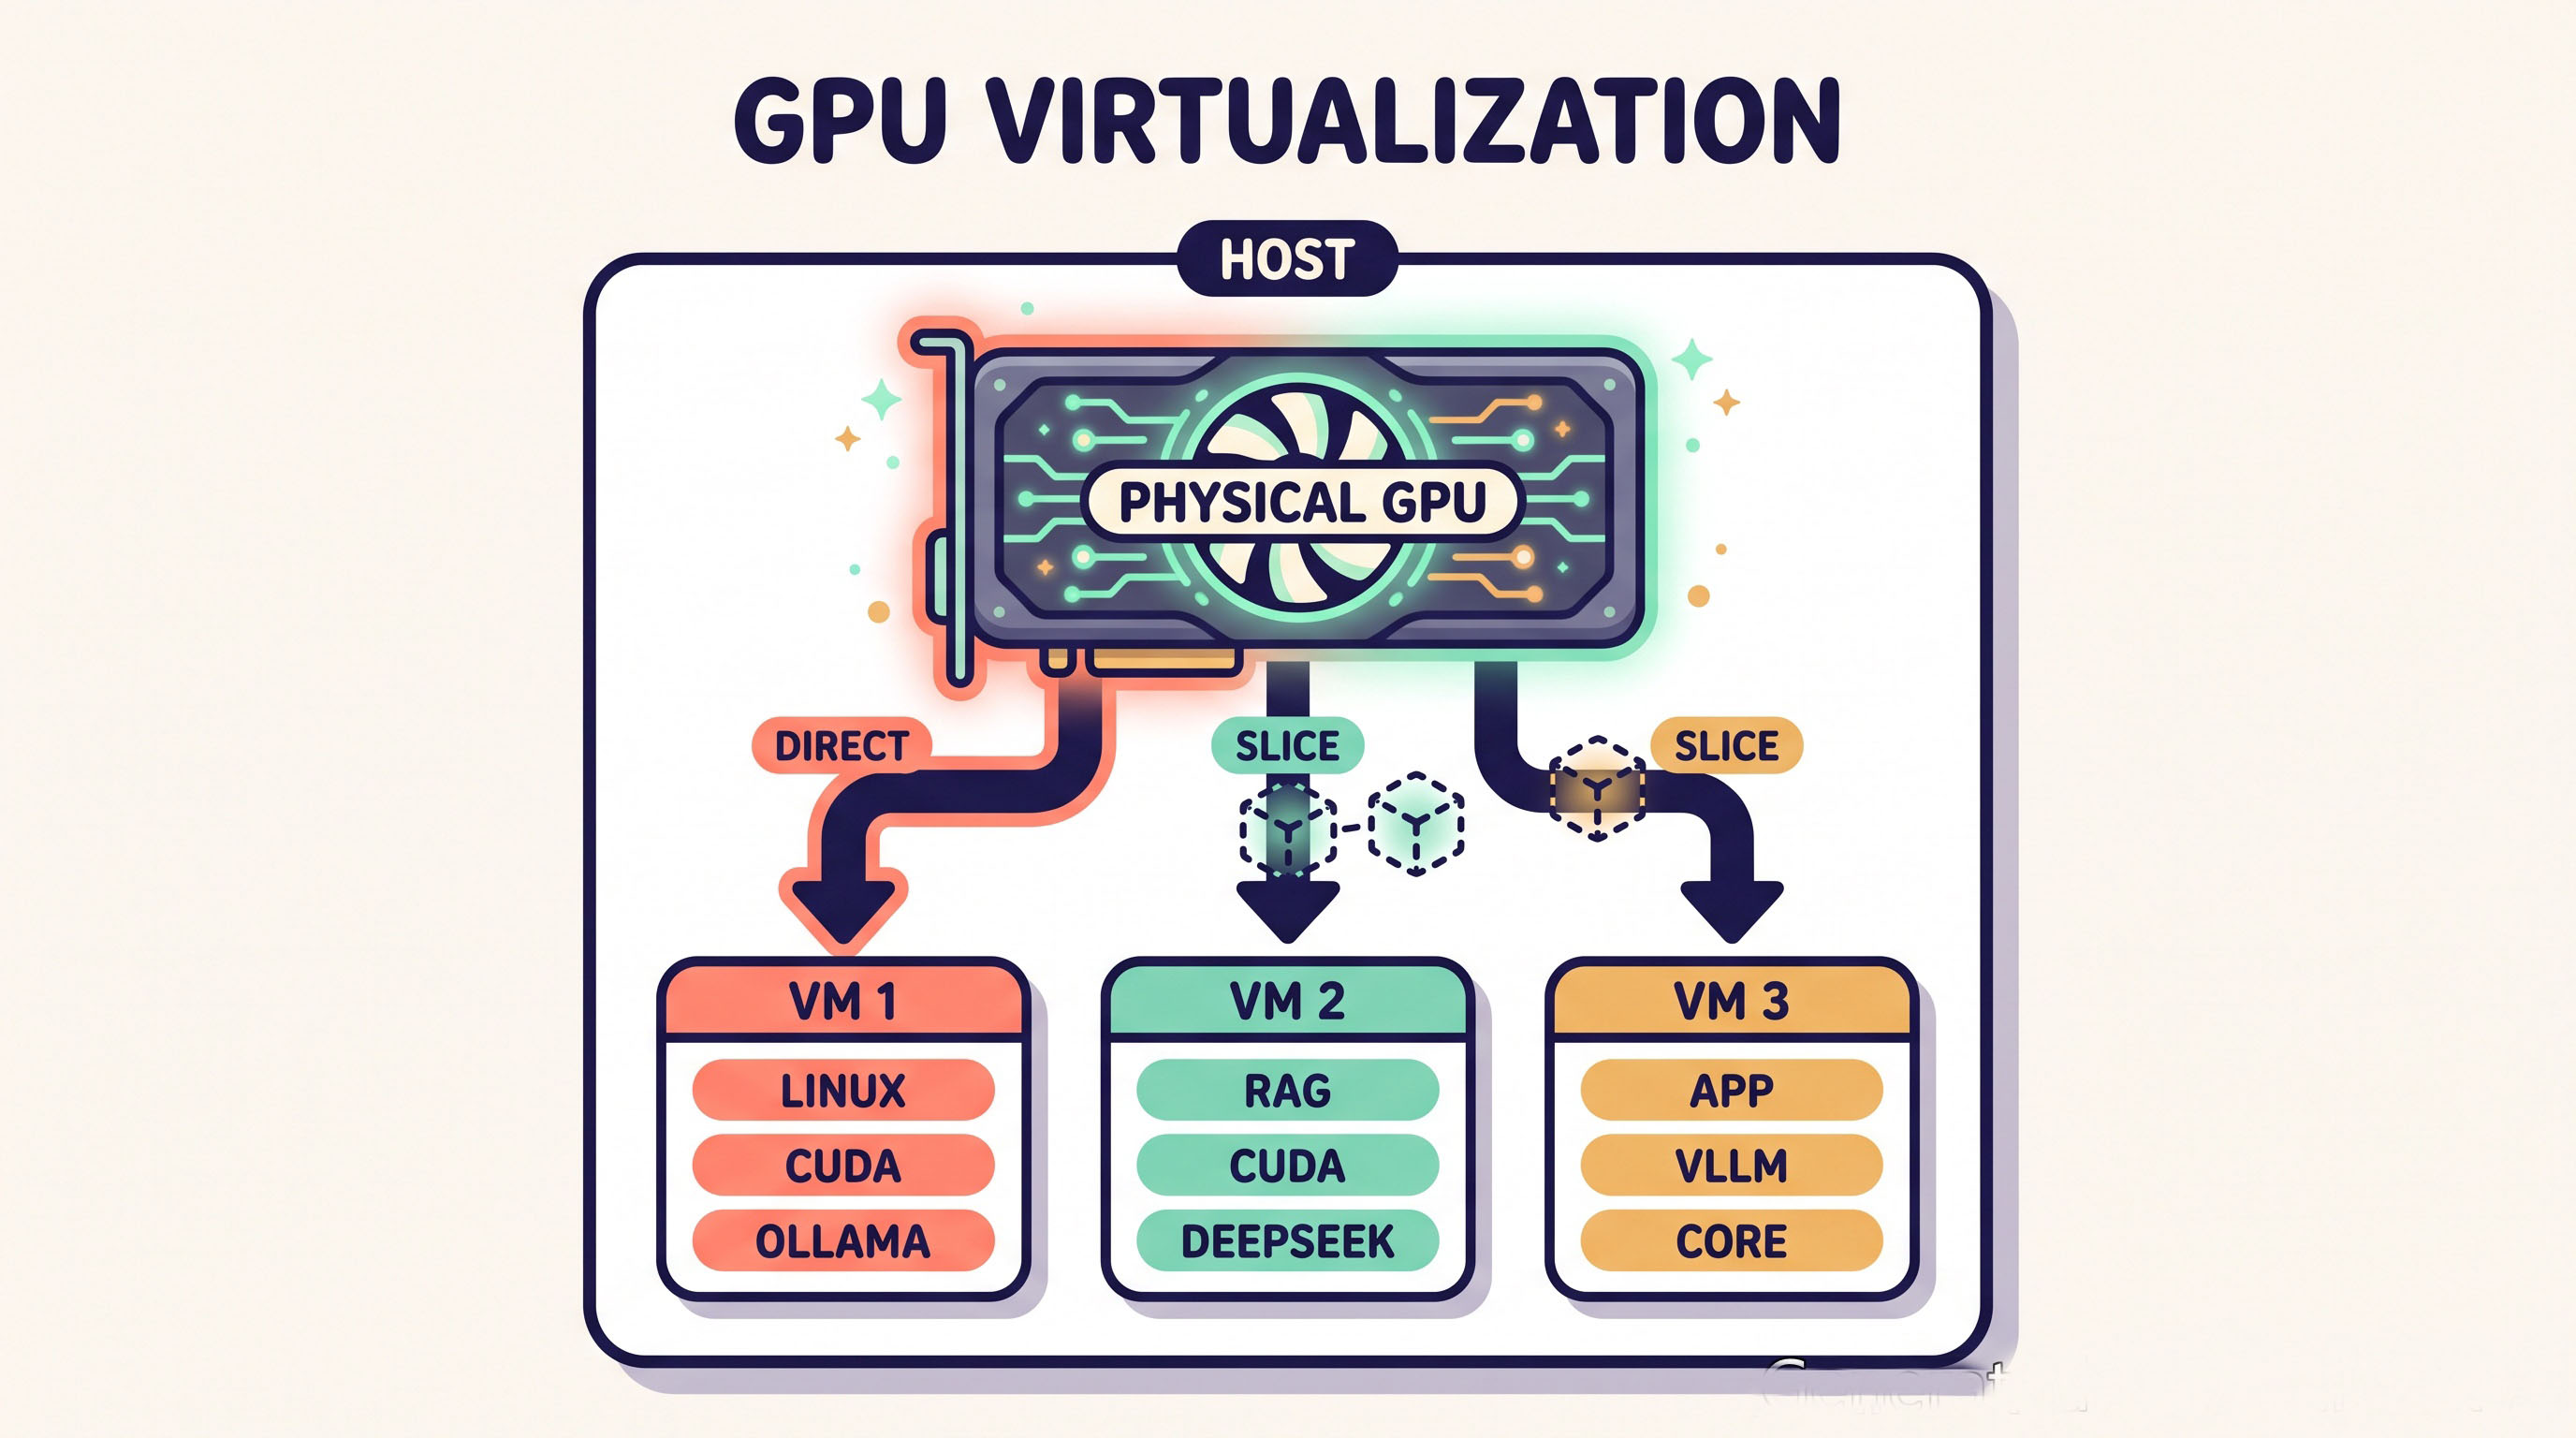
สถาปัตยกรรม GPU Virtualization & Passthrough
แตะแต่ละจุดบนภาพเพื่อดูว่า Hypervisor ยุค AI จัดการ GPU ให้ VM ได้อย่างไร
CPU & RAM Virtualization
Hypervisor แทรกชั้นจำลองทรัพยากร (CPU, Memory, Storage, Network) ของ Host ให้ VM หลายเครื่องใช้
1. แนวคิด ความหมาย และประโยชน์ของ Virtual Machine
VM คือ ‘เครื่องเสมือน’ ที่ Hypervisor แบ่งทรัพยากรของเครื่องกายภาพให้หลายเครื่องใช้ — บทความนี้เล่าเส้นทางจากการนับ CPU ไปสู่ Dynamic Compute Pooling
1.1 Hypervisor ทำงานอย่างไร
Virtualization enters to solve these problems by inserting a software layer called a hypervisor on the physical hardware, partitioning and emulating resources (CPU, memory, storage, network) so many VMs — each with its own Guest OS — can run independently on a single physical server.
1.2 การเปลี่ยนแปลงโครงสร้างพื้นฐาน: จาก Bare-Metal สู่ HCI
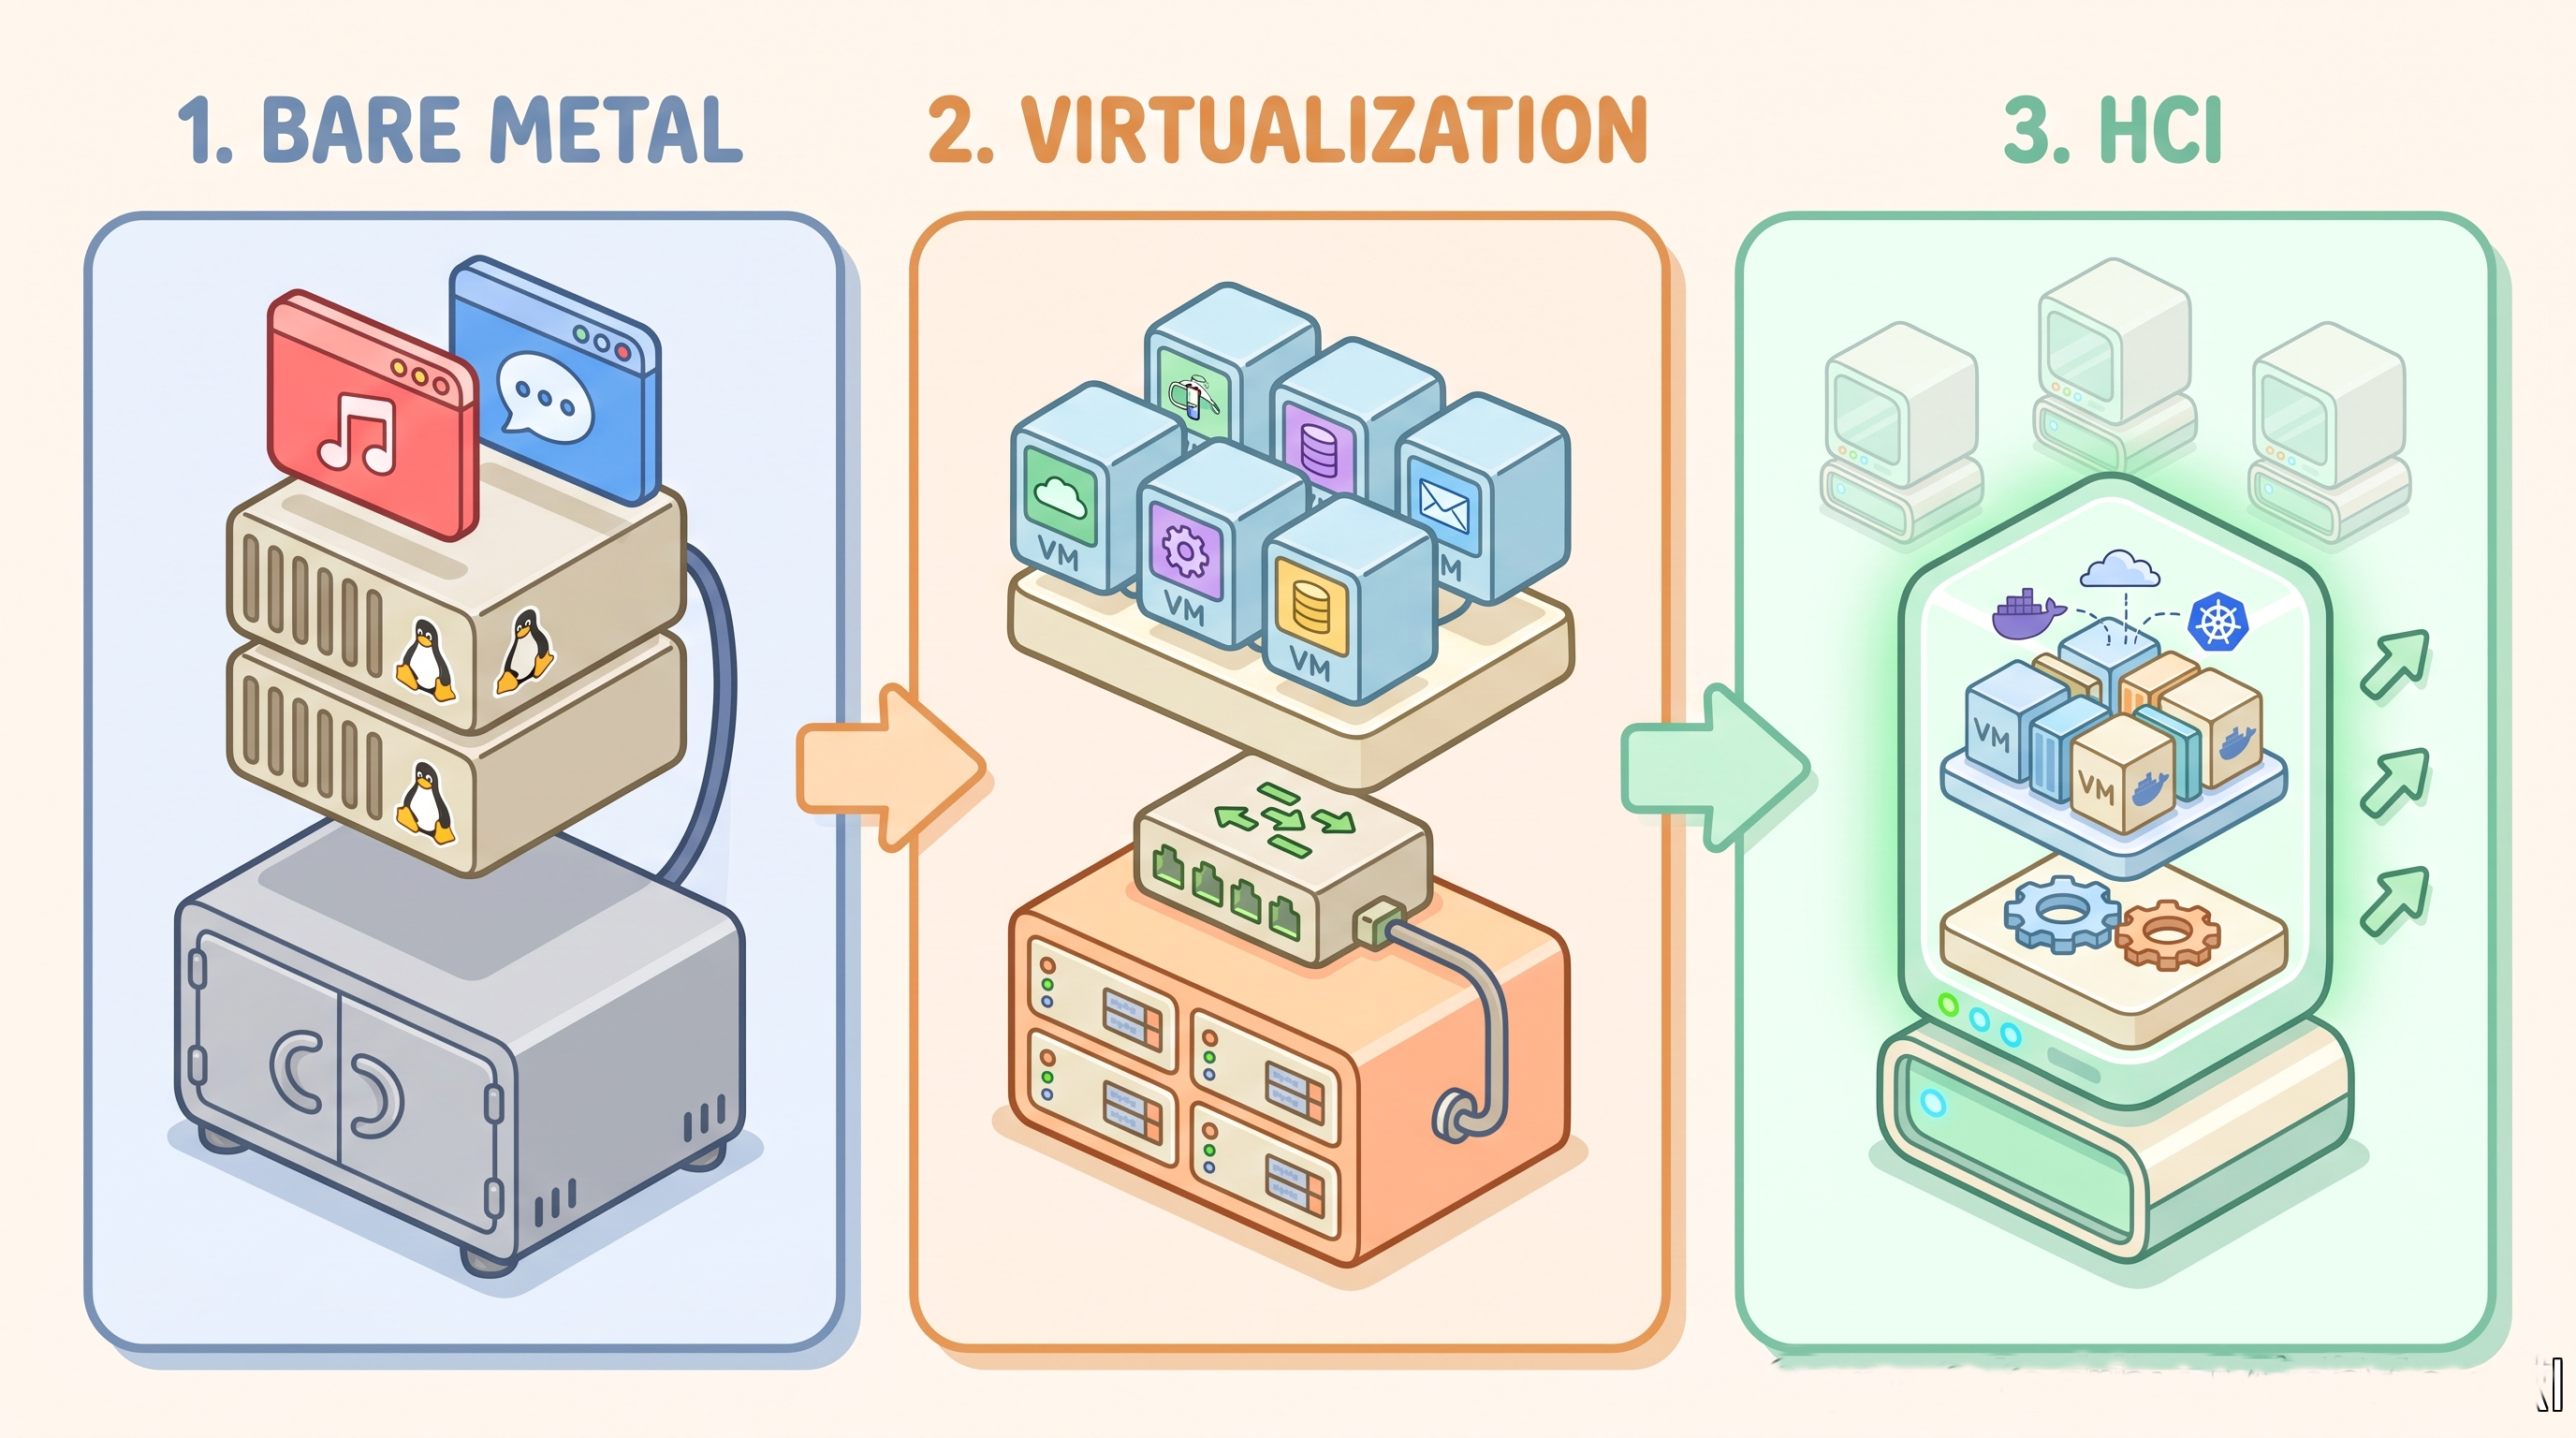
แยก Compute Server และ SAN/NAS Storage เชื่อมต่อผ่าน Fibre Channel หรือ iSCSI Switch — ต้องจัดการ Storage Array ที่ซับซ้อนและราคาสูง
รวม Compute, Storage (SDS) และ Networking ในโหนดเดียวกัน (VMware vSAN, Nutanix) — ขยายแบบ Scale-Out เพียงเพิ่มโหนดใหม่ ลดพื้นที่และสายสัญญาณ
1.3 การเปลี่ยนแนวคิด: จาก “Count per CPU” สู่ “Dynamic Compute Pooling”
ระบบ HCI ยุคใหม่เปลี่ยนจากการล็อกจำนวน CPU/Core คงที่ (Static Per-CPU Allocation) ไปสู่การมองเป็นพลังประมวลผลรวม (Dynamic Compute Pooling):
แต่ละโหนดมี Workload Profile ต่างกัน (Latency-Sensitive, Throughput-Heavy, Memory-Intensive) — การล็อก CPU ไว้ถาวรทำให้โหนดที่ทำงานเบาสบเกิด Stranded Capacity
ทรัพยากรเป็น Central Pool — เมื่อ VM เจอ Traffic พีค ระบบอนุมัติให้ดึงพลัง (GHz/MIPS/FLOPS) จาก Pool ทันที
เมื่อ VM เสร็จหรือ Idle ระบบคืนพลังและ RAM เข้า Pool ให้ VM/โหนดอื่นหมุนเวียนใช้งาน
เมื่อโหนดตึงมือ HCI ย้าย VM ไปโหนดว่างกว่าอัตโนมัติ (Live Migration) — Zero Downtime
1.4 ประโยชน์สำคัญ
Cost & Space Efficiency
ลดฮาร์ดแวร์ ประหยัดพื้นที่ Data Center, ค่าไฟ และระบบระบายความร้อน
Flexibility & Agility
สร้าง VM ใหม่ภายในไม่กี่นาที ตอบธุรกิจได้เร็ว
Higher Consolidation Ratio
รองรับ VM มากขึ้นบนฮาร์ดแวร์เท่าเดิม จากการแบ่งพลังประมวลผลจริง
HA & Disaster Recovery
ย้าย VM ข้ามเครื่อง Real-time และ Failover ไป Data Center สำรองผ่าน Image
2. การวิเคราะห์ตลาด Virtualization ปัจจุบัน
ตลาด Hypervisor ยึดครองโดย Broadcom/VMware นานหลายสิบปี และกำลังถูกท้าทายจาก Hardware Vendor และ Open Source
2.1 Broadcom / VMware: การเปลี่ยนโมเดลธุรกิจ
เปลี่ยนจากใบอนุญาตซื้อขาดเป็น Subscription Only — ลูกค้าต้องจ่ายรายปี
ยกเลิกขายผลิตภัณฑ์แยก (เช่น vSphere Standard) บังคับรวมเป็น VMware Cloud Foundation (VCF) หรือ vSphere Foundation (VVF)
TCO สูงขึ้น 2–5 เท่า — องค์กรทบทวนยุทธศาสตร์และมองหา Alternative Hypervisors เพื่อลดความเสี่ยงงบประมาณ
2.2 การปรับตัวของ Hardware Vendor
ผู้ผลิตฮาร์ดแวร์รายใหญ่ (Lenovo, HPE, Dell) ปรับกลยุทธ์เพื่อรองรับพฤติกรรมลูกค้าที่เปลี่ยนไป:
Lenovo (ThinkAgile), HPE (ProLiant/SimpliVity) และ Dell (PowerEdge/VxRail) เพิ่มการรองรับ Nutanix AHV, Red Hat OpenShift Virtualization และ Microsoft Hyper-V
ร่วมมือกับผู้ให้บริการ Open Source ระดับ Enterprise จัดชุดฮาร์ดแวร์ที่พร้อมรันระบบทางเลือก ตอบโจทย์ลูกค้าที่ต้องการลดต้นทุนลิขสิทธิ์
3. การเข้าสู่ยุค AI Local และบทบาทใหม่ของ Virtualization
การเติบโตของ LLM และ Generative AI เปลี่ยนการประมวลผลจาก Cloud AI สู่ AI Local (Edge AI / On-Premises AI) เพื่อแก้ปัญหา Data Privacy และ Latency
3.1 Native Linux & Ecosystem
การมาของ AI Local เปลี่ยนทั้ง Stack ที่โมเดลทำงานอยู่ และเปลี่ยนหน้าที่ของ Hypervisor ไปพร้อมกัน:
โมเดล Open-Source AI (Llama, DeepSeek, Mistral) และ AI Frameworks (PyTorch, TensorFlow, CUDA) ถูกพัฒนาและ Optimize ให้ทำงานบน Native Linux ได้ประสิทธิภาพสูงสุด
Ecosystem ของ OS สมัยใหม่ (Android, iOS/macOS) เพิ่ม H/W Acceleration (Neural Engine) มาในตัวเครื่องทุกเครื่อง
VM แบบเดิมที่จำลองเพียง CPU/RAM ไม่เพียงพออีกต่อไป Hypervisor ต้องจัดการ GPU ให้ VM ได้อย่างมีประสิทธิภาพ
3.2 Proxmox VE: Open-Source Hypervisor
จากปัญหาค่าลิขสิทธิ์ของ VMware ประกอบกับความต้องการรัน AI ที่ยืดหยุ่น Proxmox Virtual Environment (PVE) — Type-1 Hypervisor Open-Source (Debian + KVM) — ได้รับความนิยมสูง โดยเฉพาะสถานศึกษา หน่วยงานวิจัย และงานที่ไม่ Mission-Critical
ใช้งานฟรีเต็มฟังก์ชัน (จ่ายเฉพาะ Enterprise Subscription Support เมื่อต้องการ)
มี Backup, Live Migration, Storage Virtualization (ZFS, Ceph) ในตัวโดยไม่ต้องซื้อ Add-on
พัฒนาบน Linux kernel ปรับแต่งสคริปต์และ Libraries การจัดการได้เป็นอิสระ
3.3 เทคโนโลยีจัดการ GPU สำหรับ AI & RAG
การนำ AI มาใช้ภายในหน่วยงาน เช่น RAG (Retrieval-Augmented Generation) เพื่อค้นหาเอกสารภายใน จำเป็นต้องพึ่ง GPU — Hypervisor สมัยใหม่ต้องรองรับ 3 รูปแบบหลัก:
| เทคโนโลยี GPU | ลักษณะการทำงาน | เหมาะสำหรับ |
|---|---|---|
| GPU Passthrough | มอบ GPU กายภาพทั้งใบให้แก่ VM 1 เครื่องโดยตรง — VM ได้ประสิทธิภาพเทียบ Bare-Metal | Training โมเดลขนาดใหญ่ / LLM ที่ต้องการ VRAM & Compute สูงสุด |
| NVIDIA vGPU | ซอฟต์แวร์จำลองแบ่ง GPU 1 ใบเป็น vGPU หลายใบให้ VM หลายเครื่องใช้พร้อมกัน | Desktop (VDI), Dev, หรือ VM Microservices AI ขนาดเล็ก |
| NVIDIA MIG | แบ่ง GPU (Ampere ขึ้นไป: A100, H100) เป็น Instance อิสระระดับ Hardware Isolation | RAG Inference / รันโมเดล AI หลายตัวพร้อมกันระดับ Enterprise |
4. อัตราส่วนความหนแน่น (Consolidation Ratio) & ข้อจำกัด
การเปลี่ยนจาก Bare-Metal สู่ HCI เพิ่ม Consolidation Ratio จาก 1 Server : 3–5 VMs สู่ระดับที่สูงขึ้นตามลักษณะงาน:
4.1 อัตราส่วนแยกตามประเภท Workload
| Workload | อัตราส่วน | ปัจจัยสนับสนุน |
|---|---|---|
| VDI (Virtual Desktop Infrastructure) | 1 Host : 100–200+ VMs | Memory Page Sharing / RAM Deduplication — OS ซ้ำถูกแชร์ใน Pool |
| Server Consolidation & Web Microservices | 1 Host : 30–60 VMs | vCPU Overcommit 4:1–8:1 + Dynamic Resource Allocation |
| Database & Heavy Analytics | 1 Host : 8–15 VMs | SDS บน NVMe + Deduplication & Compression ลด I/O Wait |
4.2 ข้อจำกัดและการออกแบบความเสี่ยง
แม้เทคโนโลยีจะรองรับการอัด VM ได้สูง การออกแบบองค์กรต้องคำนึงถึง:
วาง VM เยอะเกินไป (เช่น 150 VMs) ใน Hostเดียว เมื่อฮาร์ดแวร์พัง ระบบทั้งหมดหยุดพร้อมกัน
HCI Cluster ต้องมีทรัพยากรว่างไว้เสมอ — โหนดที่รอดต้องรับ VM ที่ Live Migration ได้
สำหรับงานทั่วไป ตัวเลขที่เหมาะสมและปลอดภัยที่สุด คือ 1 Host : 30–50 VMs
5. บทสรุป: ทิศทางอนาคตของ Virtualization
VM เปลี่ยนบทบาทจากเครื่องจำลอง Server สู่ AI-Enabled Infrastructure Orchestrator — องค์กรมักใช้ Hybrid Hypervisor
VMware / Nutanix: Core Business (SLA)
ระบบ Core Business ที่ต้องการความคุ้มครองตาม SLA สูง
Proxmox / KVM: AI & RAG Local
Dev/Test, งานวิจัย, สถานศึกษา หรือ AI/RAG Local — ลดต้นทุนลิขสิทธิ์
ดึงประสิทธิภาพฮาร์ดแวร์
ใช้พลัง Compute ที่แท้จริงของฮาร์ดแวร์ได้อย่างคุ้มค่า
ลดความเสี่ยง License
มี Alternative Hypervisor ลดแรงกดดันจาก Broadcom/VMware
พร้อม Local AI
GPU Passthrough / MIG รองรับ LLM & RAG ในองค์กร
Scalable & Resilient
Live Migration + HA ให้องค์กรพร้อมต่อความล้มเหลว
Supakiat L. เขียนจากงานจริงของทีมวิศวกร BKV และจะเขียนบทความใหม่ลงบอร์ดองค์ความรู้เรื่อย ๆ
ต้องการระบบ VM & HCI ที่พร้อมใช้?
ขอสำรวจหน้างาน ขอออกแบบระบบ หรือขอใบเสนอราคา — เราตอบกลับภายในเวลาทำการ